posts
Azure Communication Services se retira: cómo evaluar el impacto y planificar la migración sin improvisar
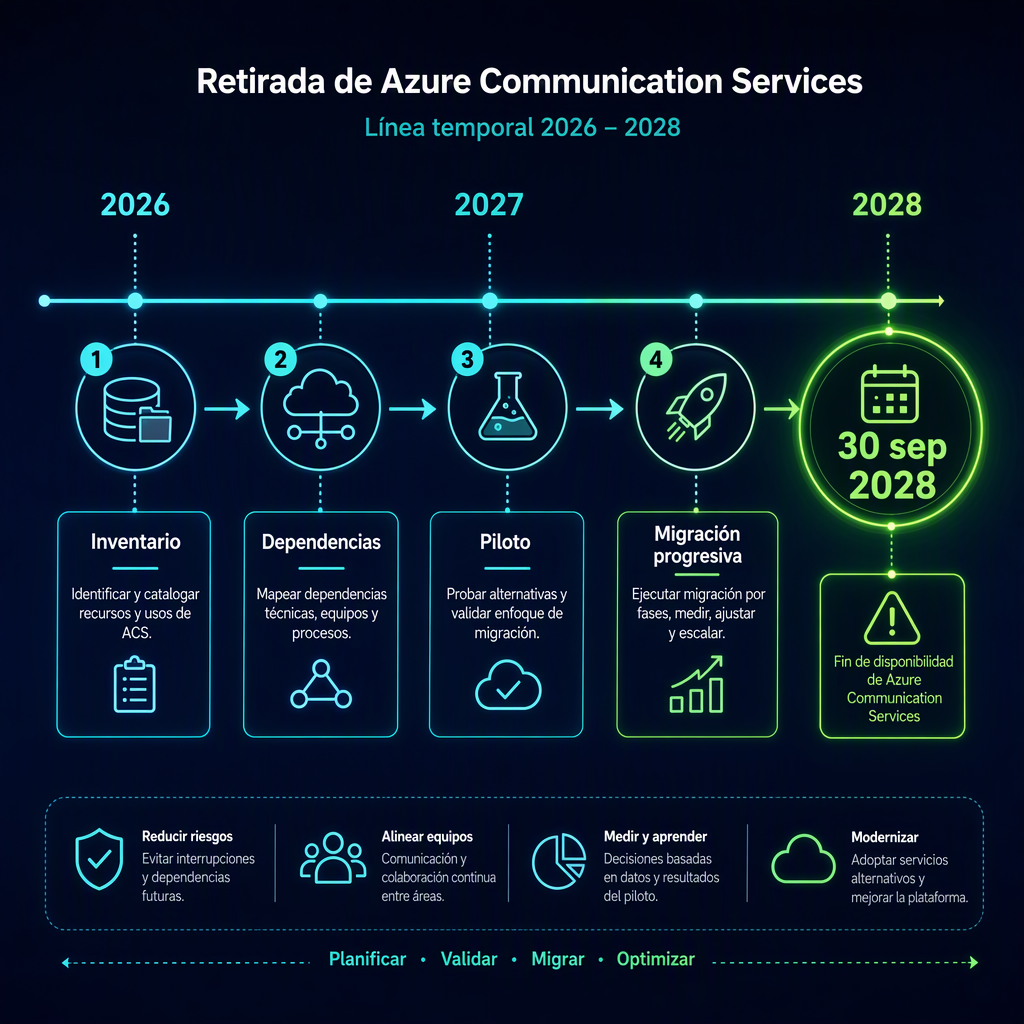
La retirada de Azure Communication Services ya no es una posibilidad difusa ni uno de esos avisos de roadmap que todo el mundo lee y luego deja para “más adelante”. Me temo que tiene tiene fecha. Tanto el anuncio publicado en la comunidad técnica de Microsoft como la guía oficial de retirada y cambios incompatibles de Azure Communication Services (ACS) dejan claro que [Azure Communication] Services como oferta independiente se retira el 30 de septiembre de 2028. Si hoy dependes de ACS para email, SMS, voz, chat o integraciones en tiempo real, yo no esperaría a 2028 para empezar a pensar qué hacer.
En mi caso, que me he especializado en agentes conversacionales (los antiguos chatbots) utilizando Azure Bot, cuando quería integrar el canal de WhatsApp en los servicios de mis clientes, en vez de pagar una cantidad importante a Twillio u otro concentrador, encontraba en ACS una relación precio-capacidades muy competitiva, muy poderosa y muy fácil de implementar e integrar. Ahora tengo que iniciar todos los procedimientos de re-arquitectura para migrar del ACS a otras soluciones y mantener el canal de WhatsApp para el chatbot… digo, el agente conversacional 😅
Y aquí está el matiz importante: el trabajo serio no consiste en “migrar rápido”, sino en entender qué has construido realmente alrededor del servicio. Esto parece una obviedad, pero en la práctica no lo es. He visto muchas veces el mismo patrón: un equipo cree que usa “un proveedor de comunicaciones” y, en cuanto empieza a tirar del hilo, aparecen reglas de negocio, automatizaciones, identidades, plantillas, webhooks, cuadros de mando (dashboards) y dependencias cruzadas repartidas por media plataforma. En ese momento, la retirada deja de ser una simple noticia de producto y pasa a ser un problema de arquitectura.
La mala noticia no es que el servicio tenga fecha de retirada; la mala noticia es no saber dónde te afecta.
Lo primero: no pienses en funcionalidades, piensa en capacidades críticas
Mi recomendación inicial es bastante poco glamurosa: deja de hablar de ACS como si fuera una única pieza dentro de tu arquitectura (aunque lo era, eso no lo discutiré) y divídelo en capacidades. No es lo mismo usar ACS Email para notificaciones transaccionales que usar voz o SMS dentro de un flujo operativo, y tampoco tiene el mismo riesgo un chat embebido en un portal que una integración de eventos conectada a procesos internos, o de nuevo en mi caso la integración con WhatsApp. Si metes todo en el mismo saco, la conversación se vuelve abstracta muy rápido y nadie prioriza bien.
Yo empezaría con una tabla viva en un documento Markdown (que además sirve para nutrir a un asistente de código como GitHub Copilot para apoyarte en la migración), no con una presentación de PowerPoint que se queda bonita una semana y vieja a la siguiente. Para cada sistema, anotaría qué capacidad de ACS consume, con qué volumen aproximado, qué proceso de negocio soporta, cuál es el impacto si falla y qué otros componentes dependen de ella. La guía oficial de ACS debería estar siempre delante como referencia e incluso descargada para emplear como skill de un agente de codificación (de nuevo yo y mi amigo GithUb Copilot), pero el trabajo real no está ahí fuera: está en tu inventario interno, en tus repositorios y en tus flujos de negocio.
Una clasificación práctica que a mí me suele funcionar es esta:
- Crítico para ingresos: confirmaciones de compra, OTP (one-time passwords o seguridad multi-factor básica), recordatorios operativos, avisos de incidencias.
- Crítico para cumplimiento o soporte: trazabilidad de comunicaciones, evidencias de envío, atención al cliente.
- Importante pero reemplazable: notificaciones internas, campañas no esenciales, avisos de baja prioridad.
- Técnicamente acoplado: uso de SDK, webhooks, plantillas, números, identidades o eventos específicos del servicio.
Ese cambio de enfoque transforma la conversación. Ya no estás preguntando “¿por qué proveedor lo sustituyo?”, sino “¿qué capacidad tengo que preservar, con qué SLA y con qué coste de cambio?”. Y esa, en mi experiencia, son las preguntas realmente útiles.
Dónde suele esconderse el impacto real
Cuando alguien me dice “solo enviamos emails con ACS”, yo suelo sospechar. No por malicia; por experiencia… y es que más sabe el diablo por viejo que por diablo, ¿no?. El impacto rara vez está solo en el punto en el que sale el mensaje. Casi siempre está en todo lo que has conectado alrededor: secretos en Key Vault, pipelines de despliegue, reglas de reintento, alertas, auditoría, consultas de logs, soporte de primer nivel y pequeñas automatizaciones que nadie documentó porque “ya las miraremos luego”… si, ya sabes… luueeeegooo.
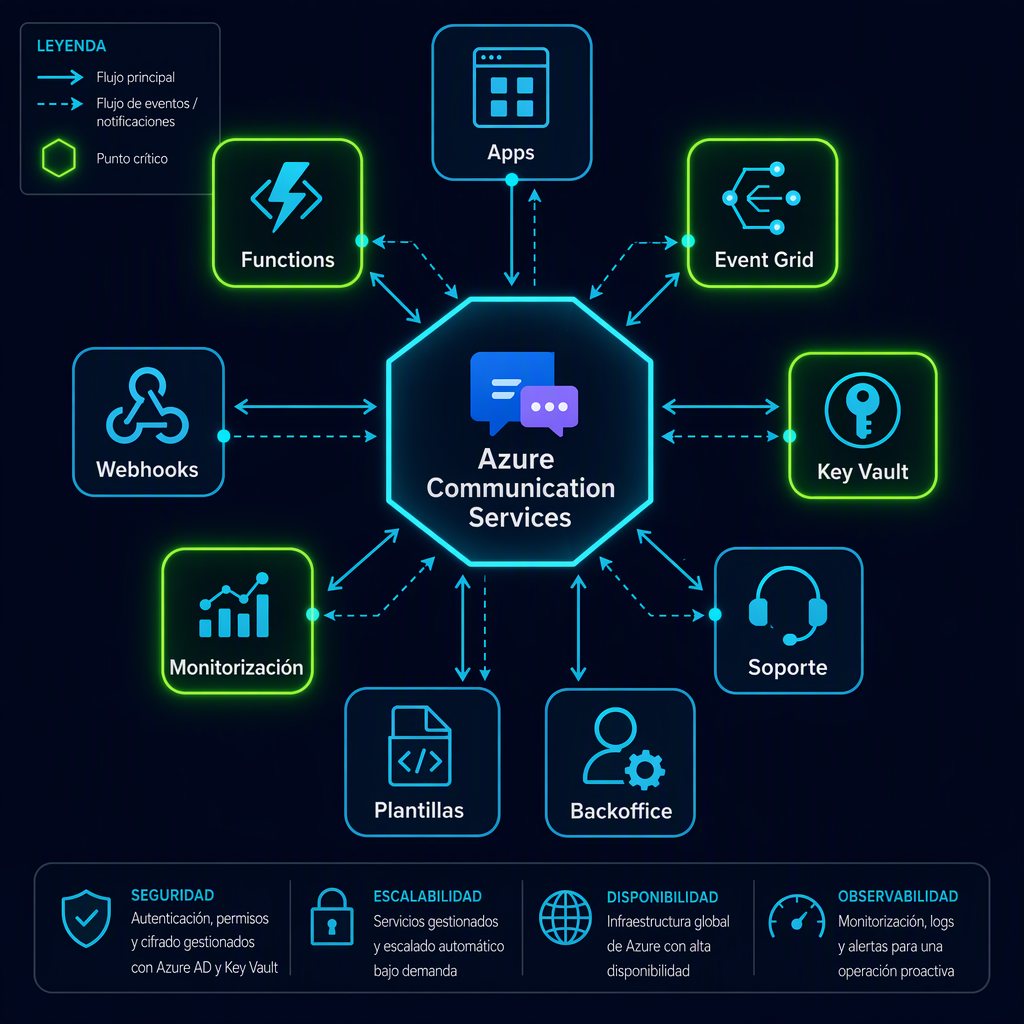
Yo revisaría, como mínimo, estas áreas:
- Código de aplicación: SDK de ACS, clientes HTTP propios, wrappers propios (custom) o internos, plantillas y serialización de payloads.
- Infraestructura: recursos de Azure, identidades administradas, RBAC (Role-Based Access Control), redes, DNS, dominios, números o configuración asociada.
- Integración asíncrona: Event Grid, webhooks, colas, funciones, procesos de reintento y compensación.
- Observabilidad: métricas, alertas, correlación, consultas de logs y cuadros operativos.
- Operación diaria: runbooks, procedimientos de soporte, escalados y gestión de incidencias.
- Contratos de negocio: tiempos de entrega esperados, evidencias, plantillas aprobadas y requisitos de cumplimiento.
Aquí hay una trampa bastante habitual: centrarse solo en “qué API tengo que cambiar” y olvidarse de “qué contrato operativo voy a romper” o que SLAs (Service Level Agreements) dejaré de cumplir. Si tu equipo de soporte sabe interpretar determinados estados de entrega, o si tu backoffice depende de ciertos eventos para cerrar un caso, cambiar de servicio sin rediseñar esos procesos es una receta estupenda para el caos. Migrar un proveedor sin migrar el modelo operativo suele salir mucho más caro de lo que parece al principio, aunque es cierto que puede ser que no sea necesario. El punto importante es verificarlo, validarlo y certificarlo para tener la certeza concreta y completa de que así es.
Cómo haría yo una evaluación seria en 30 días
Si hoy me tocara liderar esta evaluación, yo no arrancaría todavía un proyecto grande ni montaría un comité eterno (que también hay mucho de eso). Haría una fase corta, muy enfocada, de descubrimiento y decisión. En cuatro semanas puedes salir de la incertidumbre y entrar en un plan bastante razonable.
Semana 1: inventario y trazabilidad
Lo primero sería localizar todos los repositorios, funciones, aplicaciones, pipelines y scripts donde aparezca ACS. Haría búsquedas por nombres de paquetes, endpoints, variables de entorno, nombres de recursos y configuraciones relacionadas. Y no buscaría solo en producción. Muchas veces el entorno más olvidado es precisamente el que te revela integraciones antiguas que luego reaparecen en producción por sorpresa.
Si usas convenciones de nombres o infraestructura en Azure relativamente ordenada, una consulta con Azure CLI o a través de un asistente con el MCP de Azure te puede dar una primera fotografía útil:
az resource list \
  --query "[?contains(type, 'Communication')].{name:name, type:type, group:resourceGroup, location:location}" \
  --output table  # filtro inicial para localizar recursos ACS y contrastarlos con tu inventario real
No resuelve el problema, claro. Pero sí te da una primera visión rápida para contrastar lo que existe con lo que el equipo cree que existe, y esa diferencia ya suele decir bastante (también del equipo).
Semana 2: mapa de dependencias
Con el inventario en la mano, yo dibujaría el flujo extremo a extremo. Qué sistema origina el evento, qué componente decide enviar la comunicación, qué servicio la entrega, dónde vuelven los estados y quién consume esos estados. Si no puedes dibujarlo en una pizarra en diez minutos, no pasa nada… pero sí tienes una señal bastante clara de riesgo arquitectónico. El objetivo aquí no es hacer un diagrama de Visio perfecto, sino descubrir acoplamientos, zonas grises y dependencias implícitas. A veces lo más valioso de este ejercicio no es el dibujo final, sino la conversación incómoda que provoca: “espera, ¿quién consume realmente este webhook?”, “¿por qué este flujo reintenta tres veces?”, “¿quién valida estas plantillas?”. Ahí suele estar la verdad del sistema.
Semana 3: clasificación de riesgo
Para cada flujo, yo puntuaría al menos estas dimensiones:
- Impacto de negocio si deja de funcionar,
- Complejidad técnica de sustitución,
- Dependencia de características específicas,
- Esfuerzo de pruebas,
- Ventanas de cambio aceptables.
- Variación de costes.
No me complicaría con una falsa precisión de hoja de cálculo infinita. Usaría una matriz sencilla de alto, medio y bajo o rojo, amarillo y azul. No necesitas aparentar exactitud matemática; necesitas ver rápido qué tres o cuatro flujos requieren atención temprana, qué casos pueden esperar y dónde conviene hacer un piloto primero.
Semana 4: opciones y decisión preliminar
La comunicación compartida en Microsoft Community Hub insiste precisamente en eso: revisar el impacto y planificar con antelación. Para mí, esa es la clave. Este es el momento de evaluar alternativas, no de casarte todavía con una migración completa o un producto/servicio específico sólo para salir del problema. En esta fase yo buscaría encaje funcional y operativo, no solo equivalencia técnica de APIs.
Qué criterios usar para elegir alternativa
No me atrevería a recomendar una única alternativa universal, porque depende muchísimo del caso de uso y del contexto de cada organización. Lo que sí te diría es que no elijas por cercanía superficial. Que dos servicios “envíen emails” no significa que sustituyan igual tu solución actual. Y que dos plataformas tengan SDK no quiere decir que vayan a encajar igual en tu operación diaria.
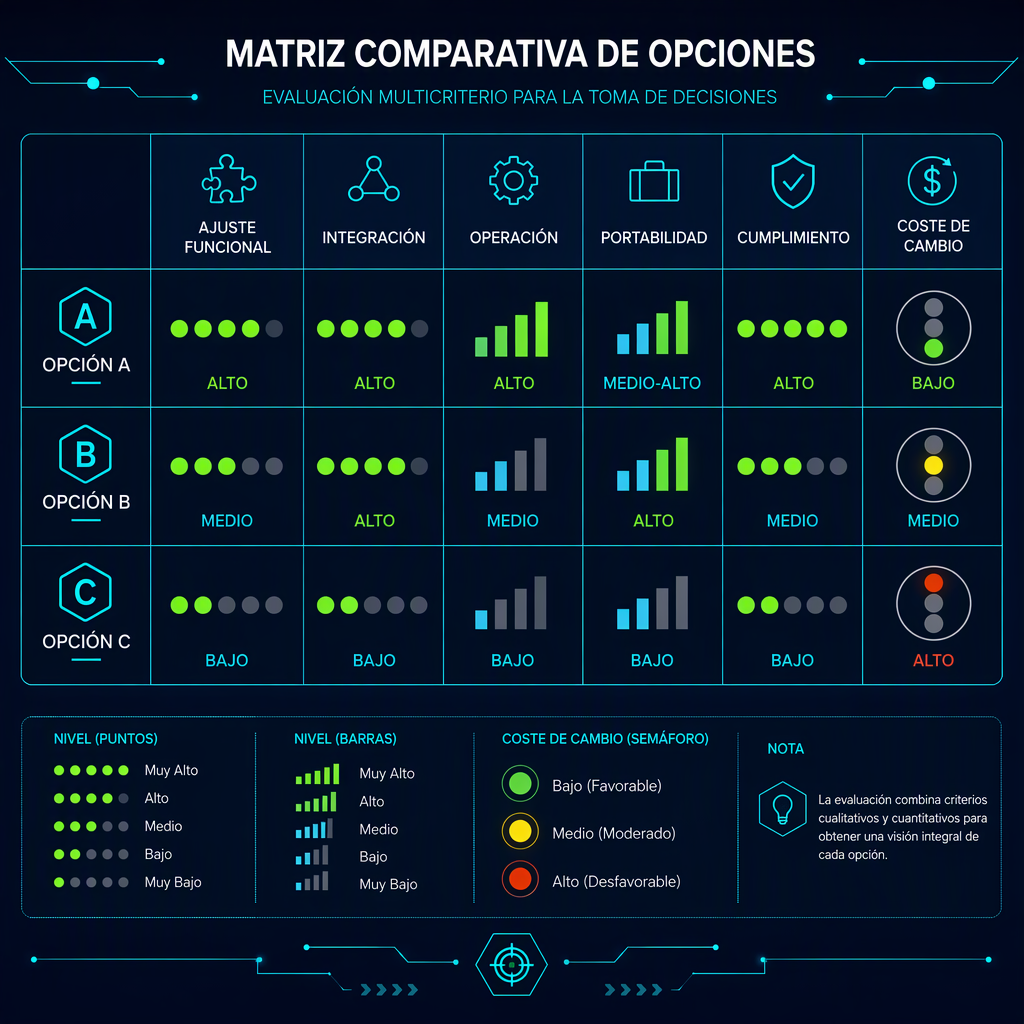
Los criterios que yo pondría encima de la mesa son estos:
- Ajuste al caso de uso: transaccional, marketing, soporte, autenticación, voz, mensajería bidireccional o colaboración.
- Modelo de integración: API, eventos, SDK, autenticación y facilidad para entornos híbridos.
- Entregabilidad y operación: reputación, estados, trazabilidad, herramientas operativas y soporte, frecuencia de actualizaciones, actividad en foros y comunidades (que tan popular es el producto, cuánta gente lo usa te ayudará a encontrar soluciones cuando te enfrentes a problemas).
- Portabilidad futura: cuánto negocio codificas contra APIs propietarias.
- Cumplimiento y datos: residencia, retención, auditoría y controles. Esto es muy importante en el contexto europeo con las leyes de privacidad (vamos, la famosa GDPR).
- Coste total del cambio: no solo licencias o consumo, también refactor, pruebas, documentación y formación.
Y aquí es donde, en mi opinión, merece la pena tomar una decisión arquitectónica un poco más ambiciosa. Si todavía no la tienes, este puede ser un buen momento para introducir una capa de abstracción de comunicaciones. Pero ojo: no hablo de un wrapper cosmético con dos métodos genéricos y nombres tan abstractos que no significan nada. Hablo de un contrato interno orientado a casos de uso de negocio: enviar confirmación, iniciar verificación, registrar entrega, notificar incidencia. Cuando haces eso bien, desacoplas el dominio de las particularidades del proveedor y te das más margen para el futuro.
El error que yo evitaría a toda costa: esperar a tener la alternativa perfecta
Muchos equipos retrasan este tipo de trabajo porque quieren resolver todas las incógnitas antes de empezar. Yo haría justo lo contrario: empezaría reduciendo incertidumbre de forma incremental. La alternativa perfecta casi nunca aparece al principio; aparece después de mapear bien dependencias, prototipar un flujo real y probar cómo se comporta en operación. Eso sí, tampoco recomiendo una migración big bang salvo que el uso de ACS sea muy pequeño y muy aislado. Si está repartido por varios dominios, lo sensato es planificar por flujos. Primero el caso más aislado y fácil de validar. Después uno de impacto medio, con más integración. Y solo cuando ya has aprendido de los anteriores, atacar lo más crítico.
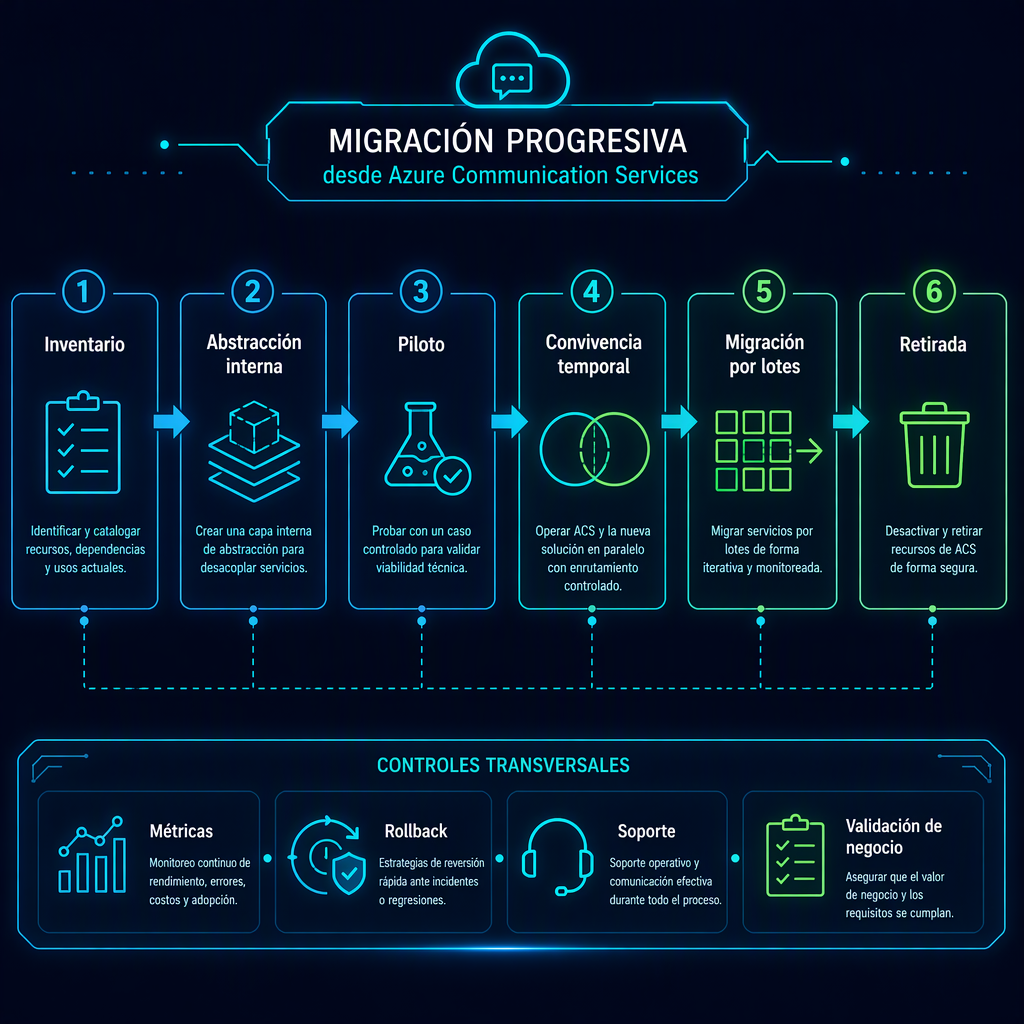
Este enfoque tiene ventajas muy concretas. Te permite validar supuestos técnicos pronto, ajustar el modelo operativo antes de tocar lo sensible y repartir el riesgo en varias ventanas de cambio. Además, deja trazabilidad útil para auditoría, para seguridad y para dirección, que en este tipo de retiradas suele hacer siempre las mismas preguntas: cuánto afecta, cuánto cuesta, qué riesgo tenemos y cuándo quedará resuelto.
Mi hoja de ruta recomendada de aquí a septiembre de 2028
Si me preguntas por una hoja de ruta sensata, yo iría más o menos por aquí:
- Ahora mismo: inventario, mapa de dependencias y clasificación de criticidad.
- En los próximos 1-2 meses: selección corta de alternativas por capacidad, no por moda ni por afinidad con un proveedor.
- Después: piloto técnico y operativo de un flujo real, con métricas, soporte y validación de negocio.
- A continuación: diseño de una capa de abstracción interna donde tenga sentido.
- Más adelante: migración progresiva por lotes, con convivencia temporal y rollback claro.
- Antes de 2028: retirada completa de ACS y limpieza de recursos, secretos, dashboards y automatizaciones antiguas. Es una buena oportunidad de limpiar la casa, deshaserce de lo redundante y de lo viejo.
Lo importante aquí es el margen. El 30 de septiembre de 2028 que marca la documentación oficial parece lejísimos… hasta que empiezas a contar dependencias, validaciones, compras, certificaciones de seguridad, pruebas, ventanas de despliegue y calendarios internos. En organizaciones medianas o grandes, ese tiempo se consume mucho antes de lo que parece desde fuera.
La idea clave con la que yo me quedaría
Esta noticia, en el fondo, no va solo de Azure Communication Services. Va de la madurez con la que gestionas dependencias de plataforma. Si tratas la retirada como una simple sustitución técnica, probablemente llegarás tarde y con poca visibilidad. Si la tratas como un ejercicio de arquitectura, descubrirás acoplamientos que ya te estaban costando agilidad aunque todavía nadie les hubiera puesto nombre.
Yo empezaría hoy mismo por algo muy poco épico: una lista de flujos, una lista de dependencias y una lista de responsables. A partir de ahí, todo mejora. La ventaja no está en reaccionar deprisa cuando se acerque la fecha, sino en haber reducido la incertidumbre mucho antes.
Comentarios